钩子事件
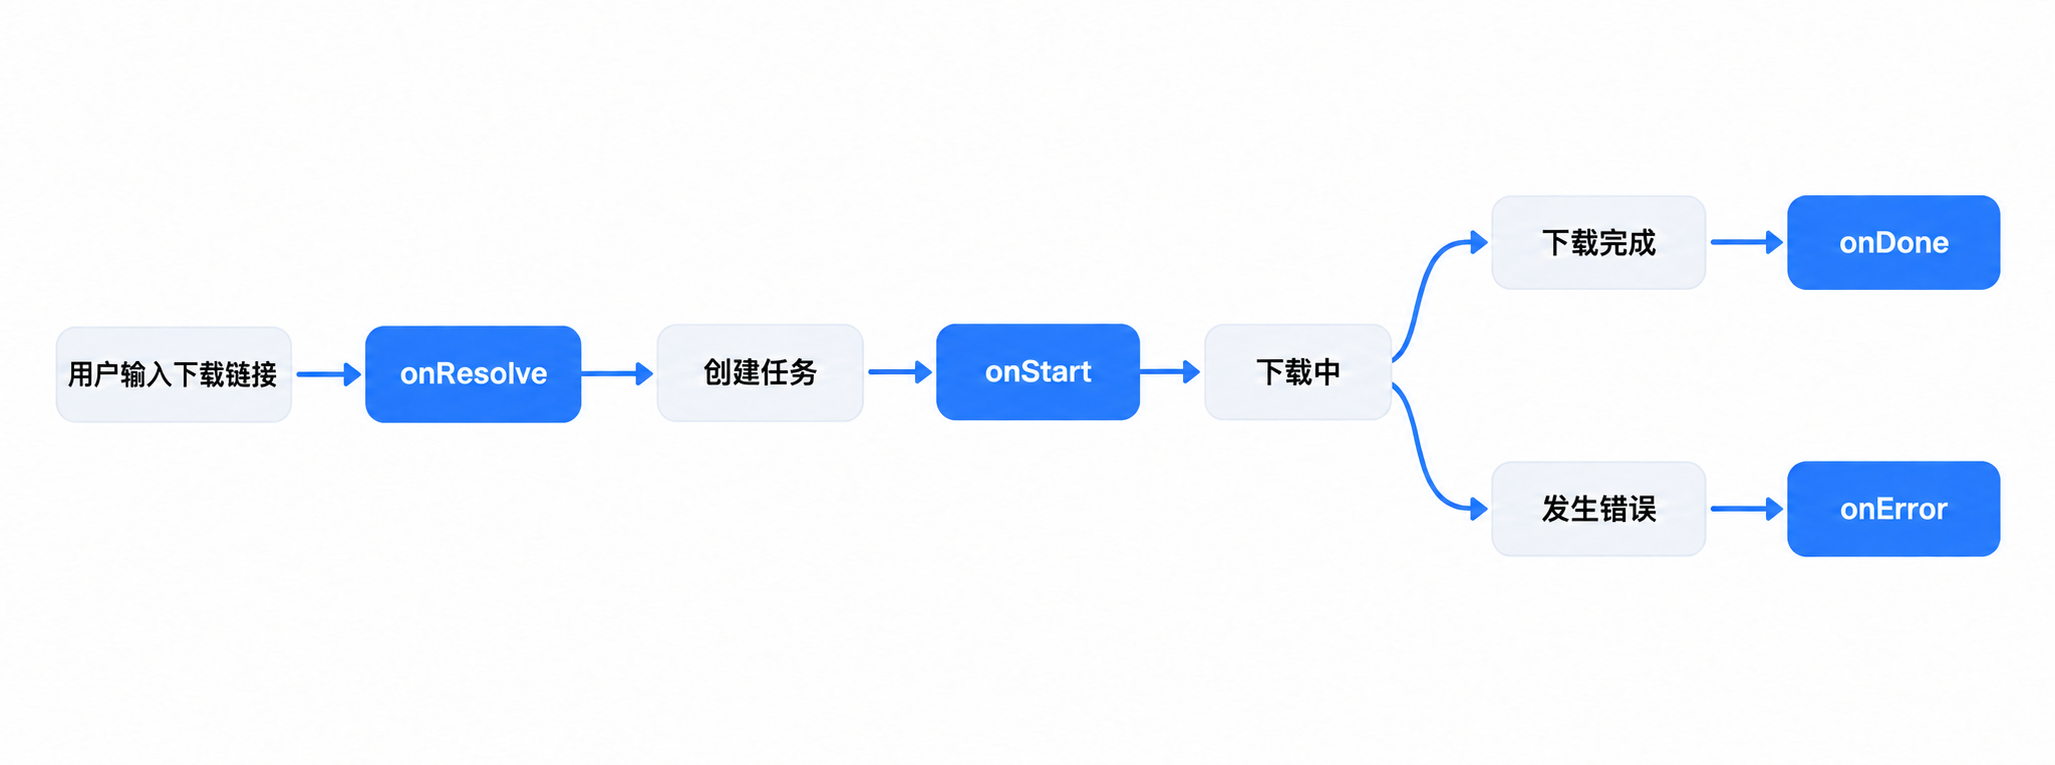
钩子事件让微应用不需要界面就能介入迅雷的下载流程:当用户创建的任务命中声明的匹配规则时,迅雷自动执行对应脚本,完成解析、改写、恢复等操作。
典型的用法是 onResolve:用户输入下载链接后,脚本请求该页面、解析出真实的文件地址,迅雷直接下载——用户全程无感。
快速示例
1. 在 manifest 中声明事件脚本:
json
{
  "permissions": ["network"],
  "network": {
    "urls": ["*://example.com/*"]
  },
  "scripts": [
    {
      "event": "onResolve",
      "match": {
        "urls": ["*://example.com/*"]
      },
      "entry": "events/onResolve.js"
    }
  ]
}
事件脚本中发起的网络请求同样受 network.urls 白名单约束,声明里一并配置。
2. 编写脚本(src/events/onResolve.ts,构建后输出为 events/onResolve.js):
ts
xunlei.events.onResolve(async (ctx) => {
  // 请求目标页面
  const response = await fetch(ctx.req.url);
  const html = await response.text();

  // 解析出真实下载地址
  const matches = html.matchAll(/href="(https:\/\/[^"]+\.zip)"/g);
  const files = Array.from(matches, (m) => ({
    name: m[1].split('/').pop()!,
    req: { url: m[1] },
  }));

  if (files.length > 0) {
    ctx.res = {
      name: '解析结果',
      files,
    };
  }
});脚本加载后会立即执行,此时必须同步完成回调注册;事件触发时迅雷调用已注册的 handler 并传入 ctx。
不要在 UI 页面注册
事件回调只能写在 scripts[].entry 指向的脚本中,与 UI 页面无关(页面没打开也会执行)。UI 页面中注册的回调不会被投递。
事件脚本运行环境
事件脚本运行在一个独立的 JS 沙箱中,特点是:
| 能力 | 说明 |
|---|---|
| 基础对象 | console、setTimeout / setInterval、URL、eval、Function 等 |
| 网络访问 | fetch / XMLHttpRequest,受 network.urls 白名单约束 |
| 平台 API | xunlei.info / logger / settings / storage / events / tasks / runtime / host.env |
| ❌ DOM | 无页面渲染能力(document 不可用) |
| ❌ 导航 | 不支持 window.open、页面跳转 |
事件脚本也能调用完整的 xunlei.tasks,例如查询或创建任务;调用时须在 manifest 中声明对应的具体权限。onStart / onError 上下文提供的请求修改与恢复方法不受这些权限控制。
脚本引擎生命周期由宿主管理:脚本运行环境的创建与销毁完全由迅雷控制——事件触发时启动(执行脚本、注册回调、执行 handler),完成后自动回收;下次事件触发时重新启动,因此不要依赖全局变量、模块级缓存等在多次触发之间传递状态。需要持久化或与页面运行时共享的数据,请写入 xunlei.storage。脚本也不应依赖(或试图干预)运行环境的存续,清理与回收由宿主自动完成。
超时限制:单次事件处理总超时约 60 秒,超时以 EVENT_TIMEOUT 失败,脚本内不要做长时间阻塞操作。
四个生命周期事件
onResolve — 解析任务
触发时机:用户提交下载请求后、创建任务前。
脚本根据 ctx.req(用户请求,只读)解析页面,把结果写入 ctx.res:
ts
interface OnResolveContext {
  req: Request; // 只读:{ url, extra?, labels? }
  res?: OnResolveResource; // 脚本写入解析结果
}

interface OnResolveResource {
  name?: string; // 任务显示名称,可省略
  size?: number; // 总大小(字节),可省略
  files: OnResolveFileInfo[];
}

interface OnResolveFileInfo {
  name?: string; // 文件名,可省略
  path?: string; // 文件相对路径,可省略
  size?: number; // 文件大小,可省略
  req: Request; // 该文件的下载请求,必填(可带 header)
}
解析结果中只有每个文件的 req 是必填项——只知道下载地址时,文件项可以仅写 { req: { url } };显式提供文件名与 path 时,注意处理非法字符与越界路径。
宿主行为:
ctx.res包含有效files时,每个file.req(含 URL、请求头等)交给下载器执行下载,res.name作为任务名;ctx.res未赋值时初始为undefined,视为该微应用不处理此 URL,宿主跳过它继续尝试其它微应用。
onStart — 任务开始前
触发时机:任务已创建、即将开始下载。可在此修改任务的请求地址、请求头与标签:
ts
xunlei.events.onStart(async (ctx) => {
  // 覆盖下载地址(如换成解析出的直链)
  await ctx.task.meta.req.setUrl('https://cdn.example.com/real-file.zip');

  // 全量替换 HTTP 请求头(仅 HTTP 任务)
  await ctx.task.meta.req.setHeaders({ Referer: 'https://example.com/watch/123' });

  // 打标签(可被同微应用的其它事件通过 match.labels 匹配)
  await ctx.task.meta.req.putLabel('source', 'miniapp');
});
ctx.task.meta.req 提供的修改方法:
| 方法 | 说明 |
|---|---|
setUrl(url) | 覆盖任务请求 URL |
setHeaders(headers) | 全量替换请求头,空对象表示清空(仅 HTTP 任务) |
putHeader(name, value) | 添加或替换单个请求头(仅 HTTP 任务) |
delHeader(name) | 删除单个请求头(仅 HTTP 任务) |
setLabels(labels) | 全量覆盖任务请求标签 |
putLabel(key, value) | 设置单个标签 |
delLabel(key) | 删除单个标签 |
控制方法返回 Promise,依赖执行结果时请 await。补充说明:
- 请求头名称原样交给宿主适配;运行时不限制名称、不会统一大小写。实际支持范围由宿主决定;
setHeaders为全量替换,遗漏的请求头即被清空,增量调整用putHeader/delHeader;- 非 HTTP 任务调用请求头方法无效果;
setHeaders参数须为对象,字段值会转为字符串; - 任务事件中的请求 URL 与标签是只读的,只能通过上述方法修改,不能直接赋值;
ctx.task.meta.req.extra不属于公开读取 API,修改请求头后也不要从中读取结果; - 修改方法成功后,当前请求的 URL / 标签快照会更新;调用失败则抛错,保留原值。
onError — 任务出错
触发时机:任务执行出错(网络错误、下载失败等)。ctx.task 可能是普通任务,也可能是任务组,通过 type 字段区分。
ts
xunlei.events.onError(async (ctx) => {
  // ctx.error(只读)为错误详情
  if (ctx.error.message.includes('403')) {
    // token 失效:刷新凭证、修正请求头后恢复任务
    const cookie = await refreshToken();

    // 任务组时 children 为命中该脚本的子任务,可逐个处理
    const tasks = ctx.task.type === 'group' ? ctx.task.children : [ctx.task];
    for (const task of tasks) {
      await task.meta.req.setHeaders({ Cookie: cookie });
      await task.continue(); // 恢复任务重新下载
    }
  }
  // 不做任何操作则按默认错误处理(任务标记为 error)
});| 字段 / 方法 | 说明 |
|---|---|
ctx.task | 普通任务或任务组;组没有 meta.req,子任务才有请求修改方法 |
ctx.error | 错误详情,只读 |
ctx.task.continue() | 恢复任务重新下载;任务组上调用则恢复整组,也可遍历 children 单独恢复 |
任务组的 children 只包含命中当前脚本的子任务;同一微应用的同一脚本入口会合并处理这些子任务。组的 id、状态及汇总信息仍指整个任务组。任务组结束时只触发一次 onError / onDone,不会为每个子任务单独触发;onStart 则按子任务逐个触发。
onDone — 任务完成
触发时机:任务所有文件下载完成。ctx.task 可能是普通任务或任务组,只读(无任何控制方法),典型用法是通知外部服务:
ts
xunlei.events.onDone(async (ctx) => {
  await fetch('https://example.com/webhook', {
    method: 'POST',
    body: JSON.stringify({
      event: 'download_complete',
      taskId: ctx.task.id,
      name: ctx.task.name,
    }),
  });
});任务组完成时同样触发一次,ctx.task.type === 'group',需要子任务明细时遍历 children。
URL 匹配规则
匹配规则分三类,从粗到细:
| 规则 | 含义 | 示例 |
|---|---|---|
<all_urls> | 全部链接都匹配 | 所有链接 |
协议:* | 只按协议过滤,不解析后续内容 | http:*、ed2k:*、magnet:* |
协议://主机/路径 | 按协议、主机和路径分别过滤 | https://*.example.com/api/*、ws://*.example.com/api/* |
<all_urls>(匹配全部)
特殊规则 <all_urls> 对任意请求地址直接命中,包括磁力链接等非 HTTP 协议,也包括空字符串和非标准 URL;下载链接是否有效仍由宿主判断:
json
{
  "scripts": [
    {
      "event": "onResolve",
      "match": { "urls": ["<all_urls>"] },
      "entry": "events/onResolve.js"
    }
  ]
}
使用约束:
<all_urls>必须单独作为完整规则书写,不能与其它段组合或拼接路径(如<all_urls>/foo属于非法写法);- 它可以和普通规则一起放在
urls数组中;只要包含<all_urls>,URL 条件就直接命中。此规则仅用于scripts[].match.urls,写在network.urls中不会放行网络请求; - 匹配所有请求意味着每个下载都会运行脚本,脚本自身应尽快判断是否处理(如检查
ctx.req.url),避免无意义的解析开销与超时风险。
协议级规则(协议:*)
写作 协议:*,只按协议过滤、不解析后续内容,没有主机与路径概念,命中该协议下的全部地址:
| 写法 | 匹配 |
|---|---|
magnet:* | 全部磁力链接 |
ed2k:* | 全部电驴链接 |
https:* / http:* | 对应协议的全部地址 |
ws:* / wss:* | 对应 WebSocket 协议的全部地址 |
协议名以英文字母开头,后续只能是英文字母或数字,匹配时不区分大小写。规则只比较链接开头冒号前的协议名,不校验冒号后的内容,因此 ed2k:* 可命中 ed2k://|file|...。不支持 *:*、magnet:*suffix 等写法;协议:* 仅用于事件匹配,写在 network.urls 中不会放行网络请求。
完整结构(协议://主机/路径)
构成为:
text
<scheme>://<host>/<path>?<query>#<fragment>scheme、host 必须书写,path 可省略(如 https://* 表示该协议下任意非空主机和路径);?query 与 #fragment 可选。匹配时各段独立比对,全部命中才算匹配成功。
scheme(协议)
协议段支持:
| 写法 | 匹配 |
|---|---|
http / https / ws / wss | 精确匹配对应协议 |
| 自定义协议 | 以英文字母开头,后续为字母或数字,如 abc、ed2k |
* | 任意协议,包括 HTTP(S)、WS(S) 和自定义协议 |
*:// 仍要求链接符合主机/路径结构;例如 *://*/* 能匹配 abc://sss,但不匹配没有有效主机结构的 ed2k://|file|...,后者可用 ed2k:* 或 <all_urls>。
host(主机)
| 写法 | 匹配 |
|---|---|
www.example.com | 精确主机 |
*.example.com | example.com 及其任意子域名(裸域本身也命中) |
* | 任意非空主机 |
*只能出现在 host 开头且紧跟.,*example.com、www.*.com均为非法写法;- 端口不参与匹配:
http://localhost/*同样命中http://localhost:3000/dev。
path(路径)
*可出现在任意位置,匹配零个或多个路径字符(不会跨过?与#);- 以
/*结尾时同时命中目录本身:/video/*既命中/video/1,也命中/video; - 结尾的
/视为可选:/video/与/video互相匹配。
query 与 fragment(可选段)
| 声明 | 匹配行为 |
|---|---|
不写 ? / # 部分 | 匹配任意查询串与锚点 |
?type=video | 要求查询串中存在 type=video,允许其它参数并存 |
?type=* | 要求存在 type 参数,值任意 |
?!type=video(! 严格模式) | 查询串只允许包含声明的参数 |
text
https://example.com/list?type=video    命中  /list?type=video&page=2(存在即可,允许并存)
https://example.com/list?!type=video   未命中 /list?type=video&page=2(page=2 未声明)
示例
| Pattern | 命中 | 不命中 |
|---|---|---|
*://github.com/* | https://github.com/xunlei/demo | https://gitlab.com/anything |
https://*.example.com/video/* | https://cdn.example.com/video/1、https://example.com/video/1、https://example.com/video | https://example.com/image/1 |
http://localhost/* | http://localhost:3000/dev | https://localhost/dev |
magnet:* | 任意磁力链接(magnet:?xt=urn:btih:...) | https://example.com/file.zip |
https:* | 任意 HTTPS 地址 | http://example.com/file.zip |
*://*/* | 任意协议且具有有效主机结构的地址,包括 abc://sss、WebSocket 地址 | magnet:?xt=urn:btih:... |
<all_urls> | 任意协议的任意地址,含磁力链接等非 HTTP 地址 | 无 |
注意事项
WARNING
- 协议与主机匹配不区分大小写,路径区分大小写;
- 当前安装时只检查规则是非空字符串;无法识别的写法(如
*:*或 host 中的*不在开头)不会匹配,也不会被当作全匹配; - 多个规则取并集:
urls数组中任一规则命中即视为匹配成功。
labels 匹配
除 URL 外,还可以按请求标签匹配(常用于微应用自身创建的任务之间的协作):
json
{
  "match": {
    "urls": ["*://example.com/*"],
    "labels": ["my-miniapp"]
  }
}labels采用存在性匹配:请求标签中存在任一声明的 key 即命中;- 同时声明
urls和labels时,任一命中即触发(两者取或)——需要「且」关系时只声明其中一组规则,把另一个条件放在脚本内自行判断; - 标签通常由
onStart的putLabel写入,供后续onError/onDone匹配。
匹配与执行流程
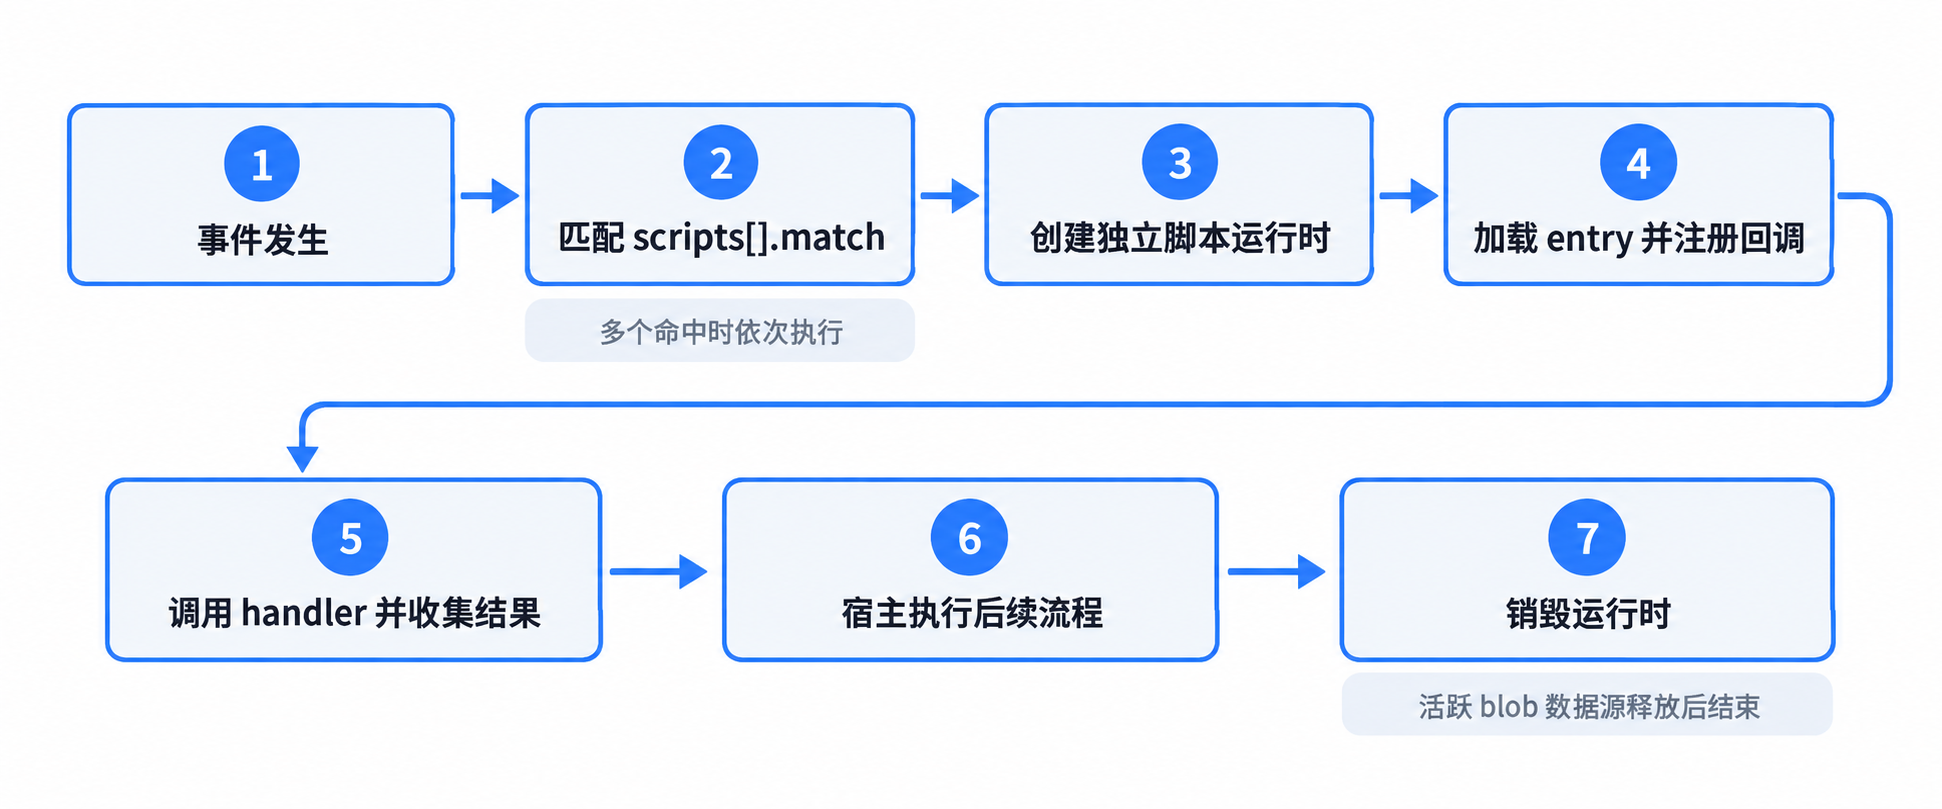
多个微应用命中同一事件时,最近安装的优先,且所有匹配项都会执行。每个匹配项使用独立运行时;存在活跃 blob 数据源时,运行时保留到数据源释放。
抛出用户可见的错误
脚本中 throw 普通错误只会记录日志;使用 MessageError 抛出的错误,宿主会以提示(toast)形式展示给用户:
ts
xunlei.events.onResolve(async (ctx) => {
  const parsed = await parse(ctx.req.url);
  if (!parsed) {
    throw new MessageError('该链接暂不支持解析,请检查后重试');
  }
  ctx.res = parsed;
});MessageError仅在onResolve事件脚本中特殊处理生效,用于交付给用户错误提示。
在事件中使用 blob
onResolve 解析出的数据可以不经过真实 URL,直接用 blob 数据源交给下载器(需要 blob 权限;运行时会保留数据源直到下载完成):
ts
const response = await fetch(ctx.req.url);
const blob = await response.blob();

const url = await xunlei.runtime.blob.createObjectURL(blob);
ctx.res = {
  name: 'downloaded.bin',
  size: blob.size,
  files: [{ name: 'downloaded.bin', req: { url } }],
};下一步
- 辅助 WebView — 在事件或页面中处理需要登录的站点
- 示例 — 完整的事件脚本示例